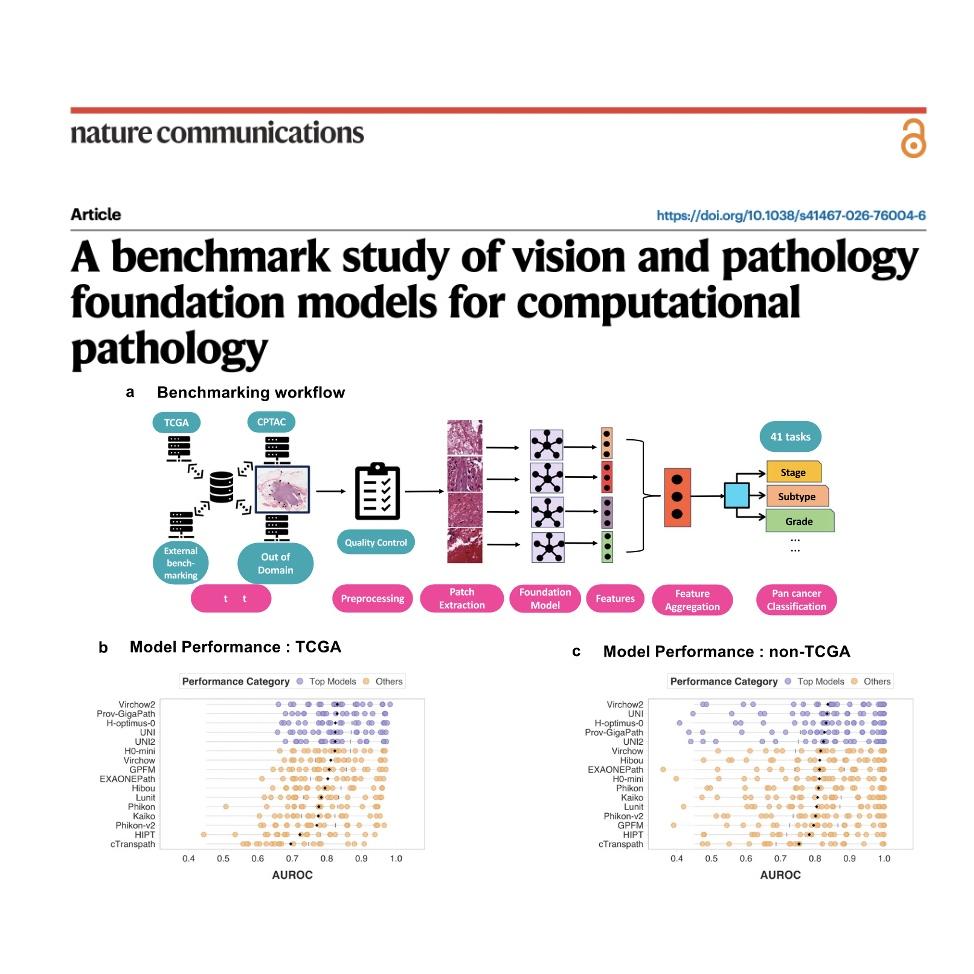
这篇研究论文对计算病理学中的32个AI基础模型进行了大规模的基准测试。研究人员对比了通用视觉模型、病理专用视觉模型以及视觉语言模型在41项临床任务中的表现,涵盖了癌症诊断、分子亚型预测和分级等多个维度。实验结果表明,病理专用视觉模型在任务的一致性和稳健性上表现最为突出,优于多模态模型。研究发现,单纯增加模型参数或预训练数据量并不能保证性能的持续提升。此外,通过模型集成策略可以有效整合不同模型的优势,从而进一步增强在复杂组织和跨领域数据集上的预测精度,为精准医疗提供了重要的参考。
References:
Bareja R, Carrillo-Perez F, Zheng Y, et al. A benchmark study of vision and pathology foundation models for computational pathology[J]. Nature Communications, 2026.